DaemonSet,它会在 Kubernetes 集群的每个节点上都运行一个 Pod,就好像是 Linux 系统里的“守护进程”(Daemon)。
1. 产生缘由
Deployment,它能够创建任意多个的 Pod 实例,并且维护这些 Pod 的正常运行,保证应用始终处于可用状态。
但是,Deployment 并不关心这些 Pod 会在集群的哪些节点上运行,在它看来,Pod 的运行环境与功能是无关的,只要 Pod 的数量足够,应用程序应该会正常工作。
这个假设对于大多数业务来说是没问题的,比如 Nginx、WordPress、MySQL,它们不需要知道集群、节点的细节信息,只要配置好环境变量和存储卷,在哪里“跑”都是一样的。
但是有一些业务比较特殊,它们不是完全独立于系统运行的,而是与主机存在“绑定”关系,必须要依附于节点才能产生价值,比如说:
- 网络应用(如 kube-proxy),必须每个节点都运行一个 Pod,否则节点就无法加入 Kubernetes 网络。
- 监控应用(如 Prometheus),必须每个节点都有一个 Pod 用来监控节点的状态,实时上报信息。
- 日志应用(如 Fluentd),必须在每个节点上运行一个 Pod,才能够搜集容器运行时产生的日志数据。
- 安全应用,同样的,每个节点都要有一个 Pod 来执行安全审计、入侵检查、漏洞扫描等工作。
这些业务如果用 Deployment 来部署就不太合适了,因为 Deployment 所管理的 Pod 数量是固定的,而且可能会在集群里“漂移”,但实际的需求却是要在集群里的每个节点上都运行 Pod,也就是说 Pod 的数量与节点数量保持同步。
所以,Kubernetes 就定义了新的 API 对象 DaemonSet,它在形式上和 Deployment 类似,都是管理控制 Pod,但管理调度策略却不同。
DaemonSet 的目标是在集群的每个节点上运行且仅运行一个 Pod,就好像是为节点配上一只“看门狗”,忠实地“守护”着节点,这就是 DaemonSet 名字的由来。
2. YAML 描述
DaemonSet 和 Deployment 都属于在线业务,所以它们也都是 apps组,使用命令 kubectl api-resources 可以知道它的简称是 ds
$ kubectl api-resources | grep daemonset
daemonsets                        ds           apps/v1                                true         DaemonSet
YAML 文件头信息应该是:
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: xxx-ds
kubectl 不提供自动创建 DaemonSet YAML 样板的功能,也就是说,我们不能用命令 kubectl create 直接创建出一个 DaemonSet 对象。
不过,可以在 Kubernetes 的官网(https://kubernetes.io/zh-cn/docs/concepts/workloads/controllers/daemonset/)上找到一份 DaemonSet 的 YAML 示例,把它拷贝下来,再去掉多余的部分,就可以做成自己的一份样板文件,大概是下面的这个样子:
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: redis-ds
  labels:
    app: redis-ds
spec:
  selector:
    matchLabels:
      name: redis-ds
  template:
    metadata:
      labels:
        name: redis-ds
    spec:
      containers:
      - image: redis:5-alpine
        name: redis
        ports:
        - containerPort: 6379
把这份YAML 和上节课里的 Deployment 对象简单对比一下,你会发现:
- 前面的 kind、metadata 是对象独有的信息,自然是不同的,但下面的 spec 部分,DaemonSet 也有 selector 字段,匹配 template 里 Pod 的 labels 标签,和 Deployment 对象几乎一模一样。
- 但是,DaemonSet 在 spec 里没有 replicas 字段,这是它与 Deployment 的一个关键不同点,意味着它不会在集群里创建多个 Pod 副本,而是要在每个节点上只创建出一个 Pod 实例。
也就是说,DaemonSet 仅仅是在 Pod 的部署调度策略上和 Deployment 不同,其他的都是相同的,某种程度上我们也可以把 DaemonSet 看做是 Deployment 的一个特例。
两者之间的差异:
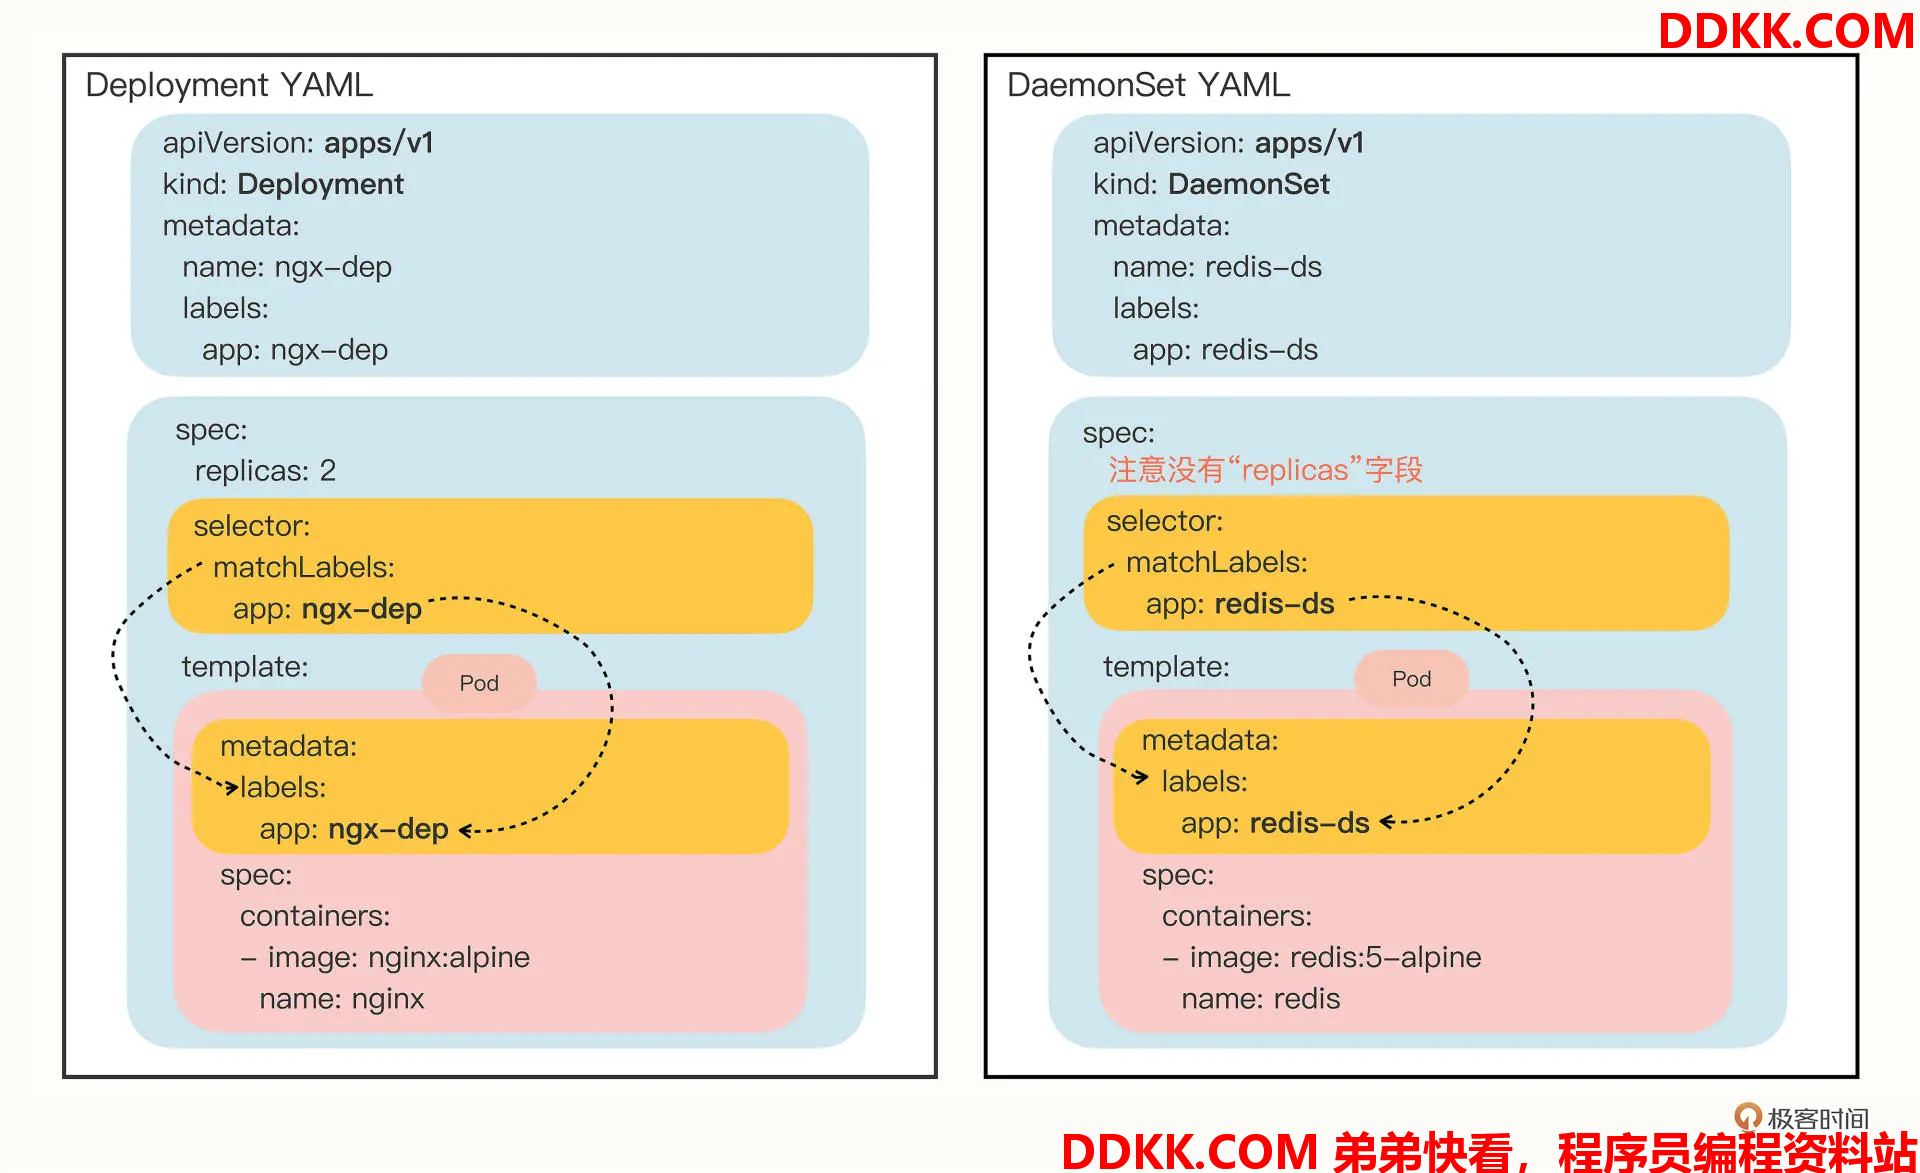
了解到这些区别,现在,我们就可以用变通的方法来创建 DaemonSet 的 YAML 样板了,你只需要用 kubectl create 先创建出一个 Deployment 对象,然后把 kind 改成 DaemonSet,再删除 spec.replicas 就行了,比如:
export out="--dry-run=client -o yaml"
# change "kind" to DaemonSet
kubectl create deploy redis-ds --image=redis:5-alpine $out
3. 使用 DaemonSet
执行命令 kubectl apply,把 YAML 发送给 Kubernetes,让它创建 DaemonSet 对象,再用 kubectl get 查看对象的状态:
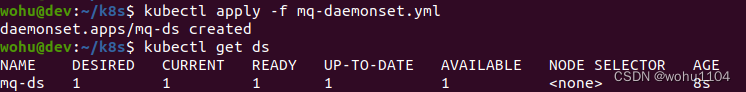
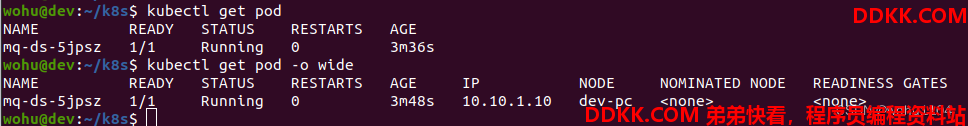
虽然我们没有指定 DaemonSet 里 Pod 要运行的数量,但它自己就会去查找集群里的节点,在节点里创建 Pod。因为我们的实验环境里有一个 Master 一个 Worker,而 Master 默认是不跑应用的,所以 DaemonSet 就只生成了一个 Pod,运行在了 worker节点上。
按照DaemonSet 的本意,应该在每个节点上都运行一个 Pod 实例才对,但 Master 节点却被排除在外了,这就不符合我们当初的设想了。
显然,DaemonSet 没有尽到“看门”的职责,它的设计与 Kubernetes集群的工作机制发生了冲突,有没有办法解决呢?
当然,Kubernetes 早就想到了这点,为了应对 Pod 在某些节点的“调度”和“驱逐”问题,它定义了两个新的概念:污点(taint)和容忍度(toleration)。
4. 污点和容忍度
“污点”和“容忍度”是与 DaemonSet 相关的两个重要概念,分别从属于 Node 和 Pod,共同决定了 Pod 的调度策略。
- “污点”是 Kubernetes 节点的一个属性,它的作用也是给节点“贴标签”,但为了不和已有的 labels 字段混淆,就改成了 taint。
- 和“污点”相对的,就是 Pod 的“容忍度”,顾名思义,就是 Pod 能否“容忍”污点。
我们把它俩放在一起就比较好理解了。集群里的节点各式各样,有的节点“纯洁无瑕”,没有“污点”;而有的节点因为某种原因粘上了“泥巴”,也就有了“污点”。Pod 也脾气各异,有的“洁癖”很严重,不能容忍“污点”,只能挑选“干净”的节点;而有的 Pod 则比较“大大咧咧”,要求不那么高,可以适当地容忍一些小“污点”。
Kubernetes 在创建集群的时候会自动给节点 Node 加上一些“污点”,方便 Pod 的调度和部署。你可以用 kubectl describe node 来查看 Master 和 Worker 的状态:
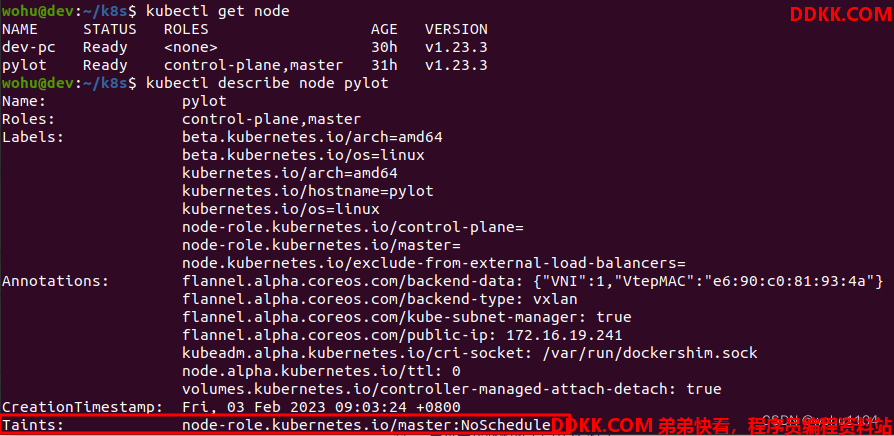
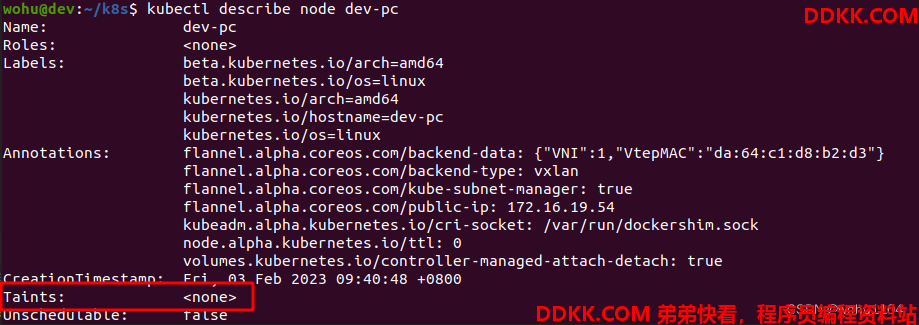
可以看到,Master 节点默认有一个 taint,名字是 node-role.kubernetes.io/master,它的效果是 NoSchedule,也就是说这个污点会拒绝 Pod 调度到本节点上运行,而 Worker 节点的 taint 字段则是空的。
这正是Master 和 Worker 在 Pod 调度策略上的区别所在,通常来说 Pod 都不能容忍任何“污点”,所以加上了 taint 属性的 Master 节点也就会无缘 Pod 了。
怎么让DaemonSet 在 Master 节点(或者任意其他节点)上运行了,方法有两种。
4.1 去掉 Master 节点上的 taint
第一种方法是去掉 Master 节点上的 taint,让 Master 变得和 Worker 一样“纯洁无瑕”,DaemonSet 自然就不需要再区分 Master/Worker。
操作Node 上的“污点”属性需要使用命令 kubectl taint,然后指定节点名、污点名和污点的效果,去掉污点要额外加上一个 -。
比如要去掉 Master 节点的 NoSchedule效果,就要用这条命令:
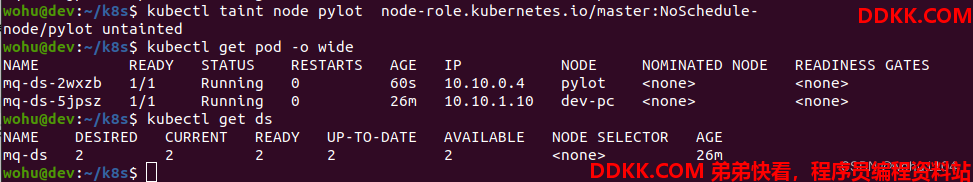
$ kubectl taint node pylot node-role.kubernetes.io/master:NoSchedule-
因为DaemonSet 一直在监控集群节点的状态,命令执行后 Master 节点已经没有了“污点”,所以它立刻就会发现变化,然后就会在 Master 节点上创建一个“守护”Pod。你可以用 kubectl get 来查看这个变动情况:
但是,这种方法修改的是 Node 的状态,影响面会比较大,可能会导致很多 Pod 都跑到这个节点上运行,所以我们可以保留 Node 的“污点”,为需要的 Pod 添加“容忍度”,只让某些 Pod 运行在个别节点上,实现“精细化”调度。
4.2 为 Pod 添加容忍度
为Pod 添加字段 tolerations,让它能够“容忍”某些“污点”,就可以在任意的节点上运行了。
tolerations 是一个数组,里面可以列出多个被“容忍”的“污点”,需要写清楚“污点”的名字、效果。比较特别是要用 operator 字段指定如何匹配“污点”,一般我们都使用 Exists,也就是说存在这个名字和效果的“污点”。
如果我们想让 DaemonSet 里的 Pod 能够在 Master 节点上运行,就要写出这样的一个 tolerations,容忍节点的 node-role.kubernetes.io/master:NoSchedule 这个污点:
tolerations:
- key: node-role.kubernetes.io/master
  effect: NoSchedule
  operator: Exists
完整yml 文件内容如下:
apiVersion: apps/v1
kind: DaemonSet
metadata:
  labels:
    app: mq-ds
  name: mq-ds
spec:
  selector:
    matchLabels:
      app: mq-ds
  template:
    metadata:
      labels:
        app: mq-ds
    spec:
      containers:
      - image: rabbitmq:latest
        name: rabbitmq
      tolerations:
      - key: node-role.kubernetes.io/master
        effect: NoSchedule
        operator: Exists
现在我们先用 kubectl taint 命令把 Master 的“污点”加上:
kubectl taint node pylot node-role.kubernetes.io/master:NoSchedule
删除该daemonset。
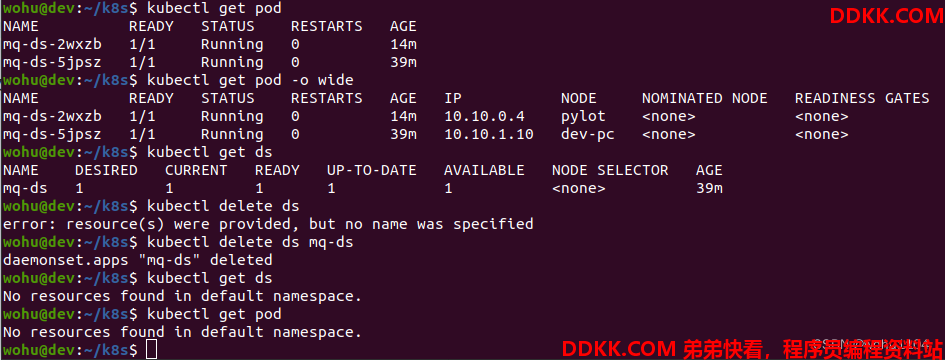
然后我们再重新部署加上了“容忍度”的 DaemonSet:
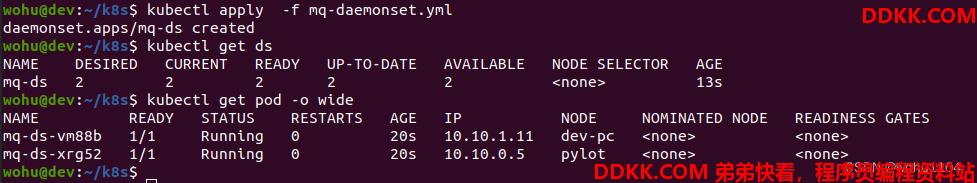
你就会看到 DaemonSet 仍然有两个 Pod,分别运行在 Master 和 Worker 节点上,与第一种方法的效果相同。
需要特别说明一下,“容忍度”并不是 DaemonSet 独有的概念,而是从属于 Pod,所以理解了“污点”和“容忍度”之后,你可以在 Job/CronJob、Deployment 里为它们管理的 Pod 也加上 tolerations,从而能够更灵活地调度应用。
至于都有哪些污点、污点有哪些效果就不细说了,Kubernetes 官网文档(https://kubernetes.io/zh-cn/docs/concepts/scheduling-eviction/taint-and-toleration/)上都列的非常清楚。
5. 静态 Pod
DaemonSet 是在 Kubernetes 里运行节点专属 Pod 最常用的方式,但它不是唯一的方式,Kubernetes 还支持另外一种叫“静态 Pod”的应用部署手段。
“静态Pod”非常特殊,它不受 Kubernetes 系统的管控,不与 apiserver、scheduler 发生关系,所以是“静态”的。
但既然它是 Pod,也必然会“跑”在容器运行时上,也会有 YAML 文件来描述它,而唯一能够管理它的 Kubernetes 组件也就只有在每个节点上运行的 kubelet 了。
“静态Pod”的 YAML 文件默认都存放在节点的 /etc/kubernetes/manifests 目录下,它是 Kubernetes 的专用目录。
下面的就是 Master 节点里目录的情况:
$ sudo ls -l /etc/kubernetes/manifests
总用量 16
-rw------- 1 root root 2242 2月   3 09:03 etcd.yaml
-rw------- 1 root root 4038 2月   3 09:03 kube-apiserver.yaml
-rw------- 1 root root 3543 2月   3 09:03 kube-controller-manager.yaml
-rw------- 1 root root 1464 2月   3 09:03 kube-scheduler.yaml
你可以看到,Kubernetes 的 4 个核心组件 apiserver、etcd、scheduler、controller-manager 原来都以静态 Pod 的形式存在的,这也是为什么它们能够先于 Kubernetes集群启动的原因。
如果你有一些 DaemonSet 无法满足的特殊的需求,可以考虑使用静态 Pod,编写一个 YAML 文件放到这个目录里,节点的 kubelet 会定期检查目录里的文件,发现变化就会调用容器运行时创建或者删除静态 Pod。
静态Pod 也可以实现和 DaemonSet 同样的效果,但它不受 Kubernetes 控制,必须在节点上纯手动部署,应当慎用。
网络插件 Flannel 就是一个 DaemonSet,它位于名字空间 kube-system,可以用 kubectl get ds -n kube-system 看到。
与“污点”“容忍度”相关的另一个概念是“节点亲和性”,作用更偏好选择哪种节点,但用法稍微复杂。
在Kubernetes v1.24 中,master 节点将不再使用污点 node-role.kuberneters.io/master 而是改成 node-role.kuberneters.io/control-plane。
6. 问题
1、 如果给一个node加上污点,那么在上面运行的不能容忍该污点的pod会自动跑到其他node上吗;
答复:如果已经调度过,运行在节点上的 pod 就不会再关心 taint 了,因为 taint 只在调度的时候生效,也可以自己试验一下。
测试结论:当 master节点去除污点时,pod会调度到 master;master 节点增加污点时,pod 不会离开,手动删除后不会再增加。
污点容忍配置路径位置:
kubectl explain ds.spec.template.spec.tolerations
1、 容忍度为什么是在pod的字段而不是ds上的;
答复:因为 Kubernetes调度的单位是 pod,DaemonSet只是管理 pod。